Die Tech-Revolution frisst ihre Kinder? Mehr Versprechen als Realität: Künstliche Intelligenz in der Softwareentwicklung

Zitat aus »Die Tech-Revolution frisst ihre Kinder?« von Nico Rohland: »Code ist nicht deshalb schlecht, weil er automatisiert erzeugt wurde. Strukturfragen verschwinden nicht, nur weil man sie nicht mehr mitdenkt.« Daneben Heftseite 45 aus lunapark21 heft 68 · Frühjahr 2026.

Die Diskussion um Künstliche Intelligenz ist von großen Versprechen geprägt. Sie reicht von radikaler Produktivitätssteigerung über die Lösung des Fachkräftemangels bis hin zu einer grundlegenden Neuorganisation von Arbeit. Auffällig ist, dass sich diese Erwartungen vor allem auf das Potenzial der Technologie richten, weniger auf ihren konkreten Einsatz.

Gerade in der Softwareentwicklung, einem der zentralen Anwendungsfelder generativer KI, zeigt sich diese Schieflage besonders deutlich. Während KI-Systeme zunehmend als »bessere Programmierer« beworben werden, bleibt die Frage weitgehend unbeantwortet, welche Rolle sie innerhalb historisch gewachsener technischer Infrastrukturen tatsächlich spielen können.

Aktuelle fundierte wissenschaftliche Beiträge lassen jedoch erkennen, dass die Auswirkungen von KI weniger gleichmäßig sind, als oft behauptet wird. Wissenschaftler:innen der Stanford University legten im November eine detaillierte Analyse zum Einfluss von KI auf den US-amerikanischen Software-Arbeitsmarkt vor.

Generation KI

Basierend auf der Auswertung umfangreicher US-Arbeitsmarktdaten zeigen sich dabei auffällige Muster: Während sich für erfahrene Beschäftigte in KI-affinen Berufen bislang kaum negative Effekte nachweisen lassen, gehen vor allem die Beschäftigungszahlen junger Berufseinsteiger:innen deutlich zurück; betroffen ist vor allem die Altersgruppe, die sich gerade im Übergang von Ausbildung oder Studium in den Arbeitsmarkt befindet.

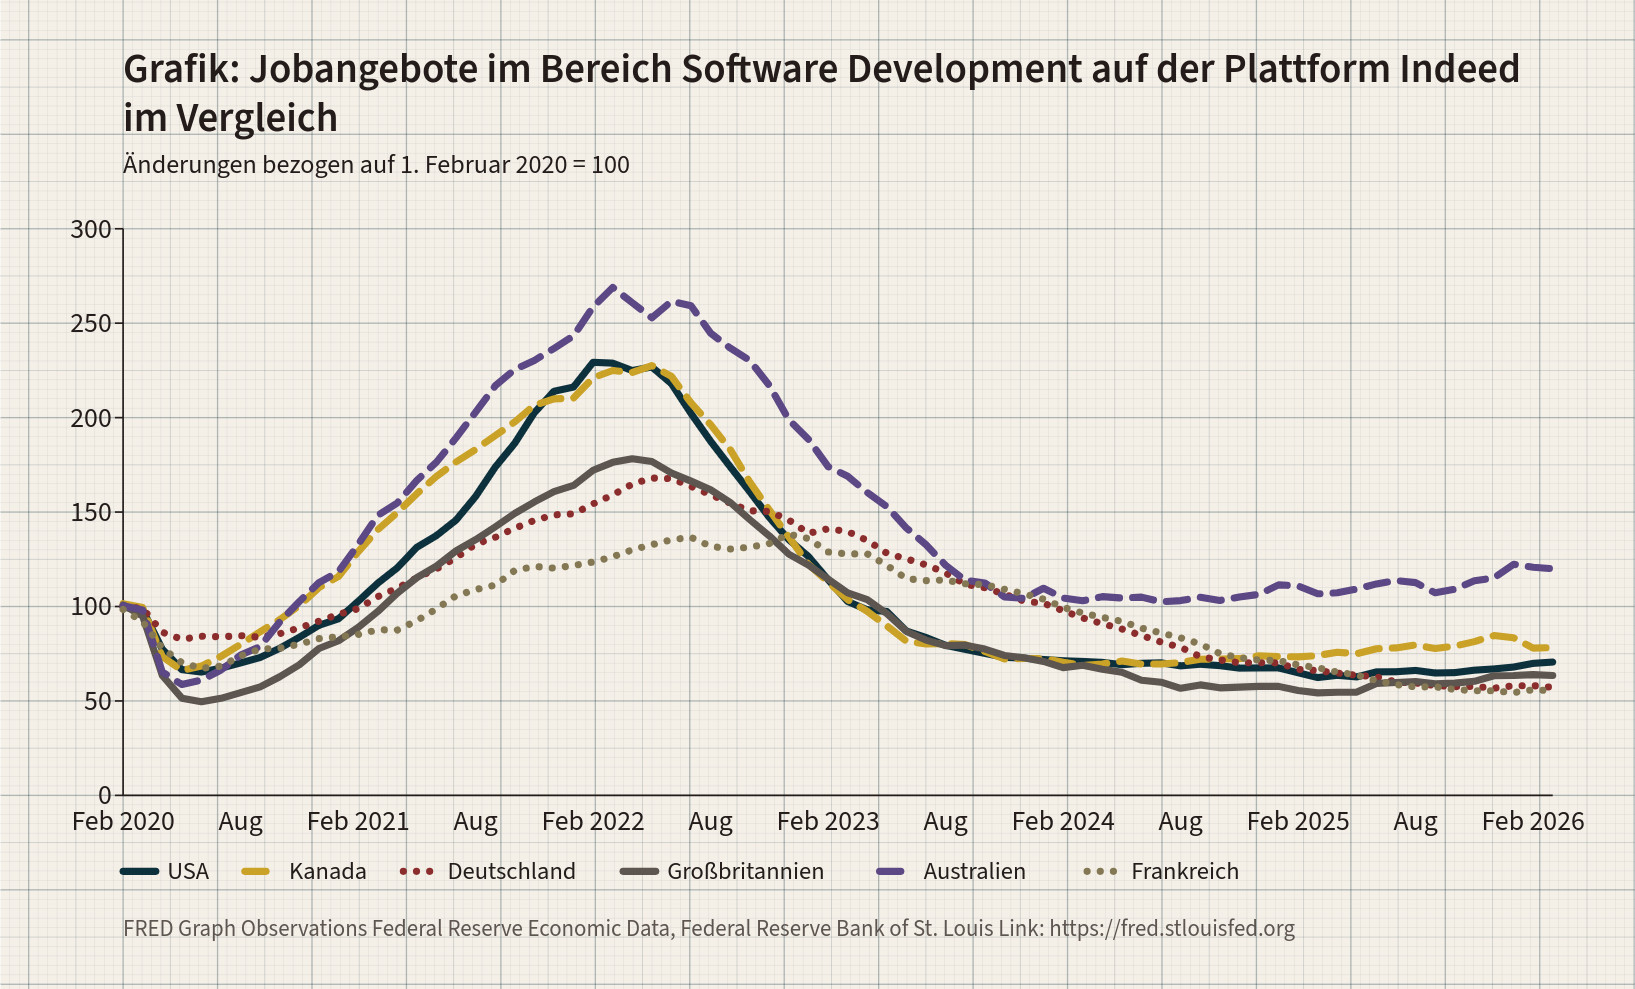
Die Zahl offener Stellen im Softwaresektor ist bereits Anfang 2023 auf das vorpandemische Niveau zurückgekehrt und anschließend weiter gefallen. Der außergewöhnliche Bedarf während der Pandemie markiert somit kein neues Normal, sondern einen vorübergehenden Ausschlag nach oben. In diesen längerfristigen Trend fügt sich die KI-Adaption ein, ohne ihn allein zu bestimmen.
Die von KI-Adaption getriebene Verschiebung auf dem Arbeitsmarkt findet nicht durch Veränderung innerhalb der bestehenden Unternehmensstrukturen statt, sondern entlang eines Generationeneffekts: Einstiegspositionen werden deutlich weniger besetzt, während die übrige Beschäftigung in großen Maßstäben unangetastet bleibt. Besonders ausgeprägt ist dieser Effekt dort, wo KI nicht als ergänzendes Werkzeug eingesetzt wird, sondern Aufgaben vollständig übernimmt.

Der bessere Programmierer

Dass gerade Junior-Stellen besonders anfällig für Verdrängung durch den Einsatz KI sind, überrascht mit Blick auf die Aufgabenstruktur nicht – zumindest auf den ersten Blick. Gestellte Aufgaben sind häufig formalisierbar, ihre Erfüllung einigermaßen objektiv messbar. Oft ähneln sie Lehrbuchfällen – ideal für KI.

Der zweite Blick könnte sich aber auf die Frage richten, wer eigentlich diese Aufgaben definiert hat. Um prototypisch bei den US-Tech-Riesen zu bleiben: Gute algorithmische Lösungen anbieten und halbwegs guten Code produzieren zu können war immer Einstellungsvoraussetzung für Juniorstellen – nicht aber ihr Zweck. Viel schwieriger als Code zu entwickeln, der ein gut beschriebenes Problem löst, ist es, sicherzustellen, dass dieser kleine Abschnitt an Code nichts anderes kaputt macht. Zu lernen, innerhalb schon vorhandener Unternehmenslogiken und digitaler Infrastrukturen selbstständig agieren zu können, ohne dabei diese sog. Sideeffects zu produzieren, ist das übergeordnete, wenn auch selten konkret ausformulierte Qualifizierungsziel vieler Juniorstellen.

Deshalb muss sich der nächste Blick auf diese Mid-Level-Positionen richten, denn hier wird aus Programmierung echte Softwareentwicklung: weg vom Lösen klar definierter Einzelprobleme, hin zur Weiterentwicklung eines historisch gewachsenen Gesamtsystems. Mid-Level-Arbeit zielt nicht darauf, Algorithmen isoliert korrekt implementieren zu können, sondern auf die Befähigung, zu entscheiden, wo im bestehenden Gefüge eingegriffen werden kann, welche Abhängigkeiten betroffen sind und welche impliziten Annahmen ein System schon in sich trägt.

Diese Fähigkeiten entstehen entlang des Qualifikationspfades, für den Junior-Stellen essenziell sind. Dort werden Erfahrungen gesammelt, wie reale Systeme auf Veränderungen reagieren, wo formalisiertes, explizites Wissen endet und implizite, nicht dokumentierte Konventionen beginnen. Fällt dieser Einstieg weg, entsteht kein unmittelbares Problem: Mid- und Senior-Level-Strukturen funktionieren weiter. Langfristig jedoch dürfte die Reproduktionsbasis dieses Erfahrungswissens wegbrechen.

Besonders deutlich wird dies bei der Fähigkeit zum systemischen Debugging: Fehler lassen sich in komplexen Softwaresystemen selten isoliert lokalisieren, sondern erfordern ein historisches Verständnis darüber, warum ein System so gebaut wurde, wie es heute ist. Es entsteht durch Teilnahme, Wiederholung und schrittweise Verantwortungsübernahme – also genau durch jene Rollen, die derzeit am stärksten unter Druck geraten.

2. Lehman’sches Gesetz

Hinzu kommt, dass Code nachvollziehbar, erweiterbar, testbar und langfristig wartbar bleiben muss; das Aufschreiben von Code für die Lösung eines algorithmischen Problems ist der kleinste Anteil der eigentlichen Aufgabe. Dieser Aufwand, eine technische Lösung auch tatsächlich einsatzbereit zu machen und dauerhaft zu halten, wird gerne als technische Schuld beschrieben und kann realisiert werden – oder eben auf später verschoben.

Bereits 1974 beschrieb Meir Lehman diesen Mechanismus präzise, ohne den Begriff der technischen Schuld zu kennen: »Während Software weiterentwickelt wird, steigt ihre Komplexität, es sei denn, es werden Anstrengungen unternommen sie beizubehalten oder zu reduzieren«. Wichtig ist die Unterscheidung zwischen komplexer Software und komplexen Aufgaben: Dass Code komplizierter wird, heißt nicht, dass er kompliziertere Probleme löst – oft ist das Gegenteil der Fall.

Zukunft Vibecode

Technische Schuld ist keine objektiv messbare Kennzahl. Untersuchungen aus den USA zeigen, dass 2022, also noch vor der weiten Adaption von KI in der Software-Industrie, etwa ein Drittel der Arbeitszeit von Softwareentwickler:innen zur Tilgung technischer Schuld verwendet wurde.

Vor diesem Hintergrund lässt sich ein Entwicklungsmuster beobachten, dass als Vibecoding bezeichnet wird: die Orientierung auf möglichst schnelle, KI-gestützte Ergebnisse bei gleichzeitigem Verlust des Blicks für das Gesamtsystem. Anforderungen werden auf hoher Abstraktionsebene formuliert, die konkrete Umsetzung an generative KI delegiert. Das Resultat kann auf den ersten Blick durchaus überzeugend sein: Scheinbar funktionierender Code überstrahlt den Infrastrukturgedanken. Der Fokus liegt auf der algorithmischen Lösung eines Problems – nicht auf der Frage, wie sich diese Lösung in ein bestehendes System einfügt, welche Abhängigkeiten sie erzeugt oder welche Erweiterungen künftig möglich bleiben müssen. Software erscheint so nicht mehr als langfristig zu wartende Infrastruktur, sondern als Abfolge isolierter Teillösungen.

Der kurzfristige Erfolg dieses Vorgehens verdeckt jedoch seine strukturelle Wirkung. Indem Lösungen ohne Blick auf das bestehende Gefüge entstehen, wächst ein System, dessen innere Ordnung nicht mitwächst. Jede weitere Änderung wird aufwendiger, riskanter und schwerer zu überblicken: Die technische Schuld wächst überproportional mit, weil der Vibecode-Ansatz eben keinen Versuch unternimmt, sie zu reduzieren oder wenigstens unter Kontrolle zu halten. Strukturfragen verschwinden nicht, nur weil man sie nicht mehr mitdenkt.
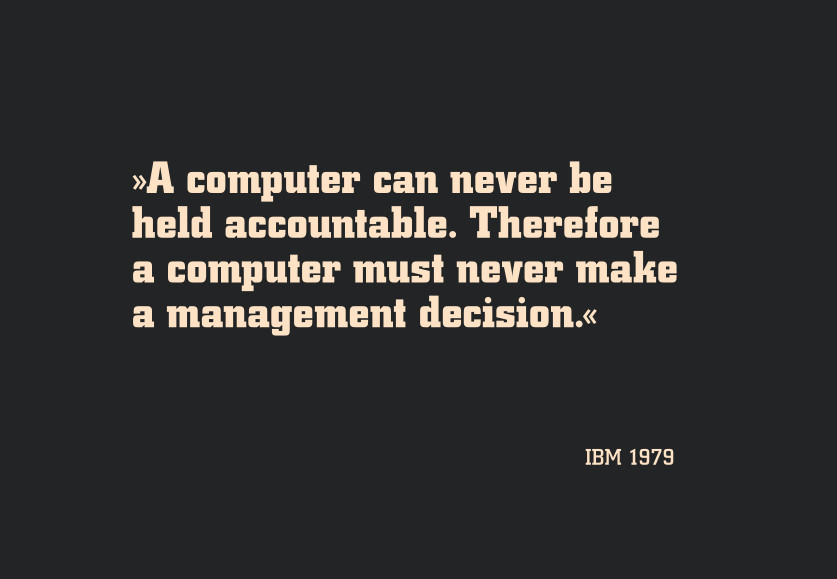
»Ein Computer kann nicht zur Rechenschaft gezogen werden. Deshalb sollte ein Computer auch niemals selbst Management-Entscheidungen treffen.« Weisheit auf einer Vortragsfolie von IBM aus dem Jahr 1979

Besonders problematisch wird diese Entwicklung dort, wo menschliches Erfahrungswissen knapp wird. Wenn Systeme zunehmend aus KI-generierten Teillösungen bestehen und zugleich weniger Nachwuchs nachrückt, verlagert sich der Aufwand von der Entwicklung hin zum Debugging – unter deutlich schlechteren Voraussetzungen. Fehler entstehen dann nicht mehr entlang nachvollziehbarer Designentscheidungen, sondern in historisch gewachsenen, inkonsistenten Strukturen, deren innere Logik erst mühsam rekonstruiert werden muss. Debugging wird damit nicht nur technisch anspruchsvoller, sondern auch ökonomisch deutlich teurer.

Beispiel Microslop

Wie Vibecoding in der Praxis aussieht, lässt sich derzeit besonders gut am Beispiel Microsoft beobachten. Kaum ein anderes Unternehmen treibt den Einsatz generativer KI so offensiv voran – sowohl in der internen Entwicklung als auch in seinen Produkten. Zugleich wird das Betriebssystem immer schwerer beherrschbar.

Windows 11 liefert dafür eine Reihe absurder Momentaufnahmen: Funktionen, die grundlegende Abläufe verkomplizieren, Notfall-Updates, um einen Rechner zuverlässig herunterfahren zu können, und ein stetiger Strom neuer KI-gestützter Erweiterungen, während bekannte Probleme bestehen bleiben. Der Eindruck entsteht, dass sichtbare Neuerungen wichtiger sind als die innere Stabilität des Systems.

Genau hier wird Vibecoding konkret. Statt bestehende Grundlagen zu vereinfachen oder zu festigen, werden neue Lösungen auf ein historisch gewachsenes System aufgesetzt. Was kurzfristig als Fortschritt erscheint, erzeugt langfristig eine Umgebung, die sich selbst blockiert: Änderungen werden riskanter, Fehler schwerer einzugrenzen, Verbesserungen immer aufwendiger. Technische Schuld wird so nicht abgebaut, sondern beschleunigt produziert.

Bezeichnend ist auch der Umgang mit dem Begriff des sogenannten »AI-Slop«, mit dem Nutzer:innen die wahrgenommene Qualitätsverschlechterung KI-generierter Inhalte beschreiben. Dass Microsoft-CEO Satya Nadella diesen Begriff öffentlich zurückwies und zugleich betonte, KI müsse in möglichst vielen Bereichen sichtbare Verbesserungen liefern, um ihre gesellschaftliche Akzeptanz zu sichern, macht deutlich: Nicht Tragfähigkeit, sondern schneller Eindruck wird zum Maßstab.

KI als Werkzeug

Der Fairness halber muss allerdings eingeschoben werden: Code ist nicht deshalb schlecht, weil er automatisiert erzeugt wurde. Automatisierte Codegeneration ist vielmehr seit Jahrzehnten eine der wichtigsten Erfolgsvoraussetzungen moderner Softwareentwicklung; sie ermöglicht u.a. erst das Entwickeln in unterschiedlichen Abstraktionsebenen. Bisher allerdings funktionierte sie grundlegend anders: Funktional stark auf einzelne Probleme beschränkt, gut erprobt und dokumentiert. Per Konzept deterministisch und reproduzierbar: Gleiche Anfragen liefern auf gleicher Hardware gleiche Ergebnisse.

Viele Aufgaben ähneln Lehrbuchfällen, sind aber im Detail aufwendig anzupassen, dort steht Zeitaufwand eben nicht in guter Relation zur Komplexität des zu lösenden Problems. Als Recherche- und Orientierungswerkzeug kann KI produktiv sein: Informationen verdichten und kontextualisieren, Wissen zugänglicher machen und den Einstieg in komplexe Problemfelder beschleunigen. Ihre Ergebnisse müssen aber kritisch geprüft und in bestehende Strukturen eingeordnet werden.

Problematisch wird KI in der Softwareentwicklung, wenn sie nicht als zusätzliches Werkzeug, sondern als Ersatz für Softwareentwickler:innen verstanden wird. Sie kann bei der Entwicklung von Code helfen, versteht aber die Einordnung in gewachsene Systeme und Infrastrukturen nicht. Die Verantwortung für funktionierende Softwaresysteme wird menschlich bleiben.

Nico Rohland, Jahrgang 1999, schreibt an seiner Master-Arbeit Computer Engineering. Hat den Kram studiert, damit er dem Computer vorschreiben kann, was er zu tun hat und nicht andersrum. Testet seit einigen Jahren studienbegleitend die Realität in einem mittelständischen Technologie-Unternehmen.

Erschienen in: Lunapark21 Heft 68 (Frühjahr 2026) || spezial: KI, Technik, Herrschaft
    Ein virtueller Wachstumsmotor? Künstliche Intelligenz in der fiktiven und realen Akkumulation

    Zitat aus »Ein virtueller Wachstumsmotor?« von Sebastian Gerhardt: »Eine menschenfreundliche Welt wäre eine, in der wissenschaftliche Fortschritte dazu da sind, das Leben zu erleichtern.« Daneben Heftseite 40 aus lunapark21 heft 68 · Frühjahr 2026.

    An der Spitze haben sie sich durchgesetzt. Angeführt von Elon Musk mit einem Vermögen von 839 Milliarden US-Dollar finden sich unter den Top 10 der Forbes 100 Liste der Milliardäre 2026 nur noch drei Herren, die ihr Vermögen nicht allein dem aktuellen Technologieboom verdanken: Der Chef des Luxusgüterkonzerns LVMH, Bernard Arnault, der Altspekulant Warren Buffet und der spanische Modezar Amancio Ortega. Die verbleibenden Plätze gehen aber nicht an alle der »Glorreichen Sieben« – Alphabet (Google), Amazon, Apple, Microsoft, Nvidia, Meta, Tesla. Die Konkurrenz ist hart.

    Mit Larry Page und Sergey Brin sitzen gleich zwei Bosse von Alphabet auf den Plätzen zwei und drei und mit Larry Ellison von Oracle hat sich gerade noch ein Vertreter der älteren Internetkonzerne oben halten können. Applemanager waren unter den Top 10 nie vertreten. Aber Steve Ballmer von Microsoft wurde erst im aktuellen Reichenranking durch den Aufstieg von Jensen Huang (Nvidia) verdrängt. Zum ersten Mal seit 1992 ist kein Microsoftboss mehr unter den Top 10 vertreten. Als Bill Gates 1997 erstmalig an die Spitze der Spitze kam, reichte dafür noch ein Vermögen von nur 36,4 Milliarden Dollar.

    Allerdings sind im letzten Jahr die Fragen lauter geworden, ob diese riesigen Vermögen auch auf einem soliden Fundament ruhen – oder ob sie nur künstliche Blüten der jüngsten Blase darstellen. Die Börsenkurse der »Glorreichen Sieben« steigen nicht mehr wie zuvor, ja einige sinken bereits. Im Dezember 2025 warnte die Bank von England vor den Risiken, wenn die umfangreichen Investitionen in die KI nicht mehr aus dem Umsatz der Technologiekonzerne bezahlt werden können. Die Börsenkurse seien wie in der Internetblase den Gewinnen enteilt. Damals verlor der Nasdaq vom seinem Höchststand Anfang 2000 in zweieinhalb Jahren 80 Prozent.

    Andere Beobachter merkten an, dass dieser Vergleich noch zu positiv ausfallen könnte. Denn die Pleiten der Jahre 2002/2003 hinterließen wenigstens Glasfasernetze, mit denen noch viele Jahre gute Geschäfte gemacht werden konnten. Ein Datenzentrum voll der neuesten Computern sei dagegen nach drei Jahren bereits veraltet. Tatsächlich geht es nicht nur um Chips. Auf jeden Fall haben die Zweifel der Investoren bereits zu ersten praktischen Reaktionen geführt. Um weitere Investitionen in Supercomputer und Datenzentren finanzieren zu können, brachte Elon Musk im Februar 2026 seine KI-Firma xAI unter das Dach des umsatzstarken Raumfahrtunternehmens SpaceX. Die Zweifel nehmen zu, ob sich die Versprechen auf große Produktivitätsgewinne durch die Anwendung der KI irgendwann realisieren lassen.

    Neue Konzepte für Big Data

    Der Terminus »Künstliche Intelligenz« hat schon in der Wissenschaft eine lange und verschlungene Geschichte. Die aktuelle Verwendung setzt zum Beispiel alles, was bis Ende der 1980er Jahre unter diesem Titel entwickelt wurde, als selbstverständlich angewandte Programmiertechniken voraus. Die seinerzeit mit diesen Mitteln verfolgten ambitionierten Ziele sind teils heute noch nicht erreicht, obwohl seitdem ganz andere Wege eingeschlagen wurden.

    Die Ursprünge der heutigen, »generativen KI« liegen in Frank Rosenblatts Modell des Perzeptrons (1957), dem ersten künstlichen neuronalen Netz mit Fähigkeiten zur Mustererkennung. Er legte damit den Grundstein für ein neues Paradigma statistischer Analyse. Mustererkennung zielt nicht darauf, eine exakte Lösung für ein Problem zu finden. Sie zielt darauf, in einer ersten Phase mit vertretbarem Aufwand Strukturen in irgendwie gegebenen Trainingsdaten auszumachen. Heutige Lernalgorithmen sind weit über die Möglichkeiten des Perzeptrons hinaus. Ob aber die verarbeiteten Daten eine Realität richtig beschreiben, das liegt in der Verantwortung der Anwender. Für die Algorithmen ist es unerheblich. Auch so hat es Jahrzehnte gedauert, bis die mathematischen Grundlagen der statistischen Lerntheorie (Vladimir Vapnik) durch eine Vielzahl von Forschern ausgearbeitet und schließlich sogar anwendbar gemacht werden konnten.

    Die Paradedisziplin für die neuen Methoden war zunächst die automatische Zeichen- und später Texterkennung. OCR – optical character recognition – in frei verwendbaren Programmen ist aber nicht nur ein Ergebnis dieser Entwicklung. Sie eröffnete neben der direkten Digitalisierung durch neue mikroelektronische Messgeräte aller Art eine weitere Quelle von maschinenlesbaren Daten. Der jüngste KI-Welle ist nicht zuletzt eine Antwort auf die technischen Schwierigkeiten, die sich seit den neunziger Jahren im Umgang mit Big Data, mit Massendaten in völlig neuem Umfang, ergeben haben. Nur verbesserte neue Hardware wie Computer und Netzwerke reichte nicht aus, auch neue Software- und Softwareentwicklungskonzepte wurden gesucht. Der große Vorzug der neuen Methoden gegenüber der traditionellen Statistik besteht darin, dass bereits aus kleineren Stichproben Strukturen zur Auswertung großer Datenmengen effektiv gewonnen und laufend angepasst werden können.

    Keine verbesserte Rechenleistung kann die Frage der Quellenkritik aus der Welt schaffen, ob denn die verarbeiteten Daten eine Realität richtig beschreiben. Ohne diese Frage erhält man nur eine Illusion der Kontrolle statt einer Kontrolle der Illusionen. Es ist dann wie in dem alten Witz über den Säufer, der seine Brieftasche unter der Laterne sucht, »weil es dort hell ist.« Wirklich verrückt wird es, wenn KI auf Daten angewendet wird, die selbst mit solchen Modellen erzeugt wurden. Für diesen Fall können Forscher schon den »AI model collapse« beweisen, der dann statistisch sicher eintreten muss.

    Was bringt Geld? Der Umsatz

    Lange vor einem solchen großen Kladderadatsch spitzen sich bereits die Konflikte über den Ressourcenbedarf der neuen Technik zu: Es ist zwar nicht so, dass der Strombedarf der Datencenter der Grund für die steigenden US-Energiepreise der letzten Jahre ist, aber nicht zuletzt ihr Wasserbedarf verarmt ihre Umgebung nicht nur ökologisch. Das interessiert an der Börse wenig.

    Der Umsatz aber schon. Wird tatsächlich mit den neuen Modellen und Geschäftsmodellen Geld verdient? Im Jahr 2024 auf jeden Fall noch nicht. Ein Blick auf die Fortune 100, die einhundert umsatzstärksten US-Unternehmen relativiert den Eindruck der Dominanz der »glorreichen Sieben«. Spitzenreiter in diesem Ranking ist der Einzelhandelsriese Walmart. Auf Platz zwei folgt Amazon, das eben kein reines Technologieunternehmen, sondern ein Einzelhandels- und Logistikkonzern ist. Apple steht auf Platz vier und Alphabet auf Platz 7. Gleich vier Konzerne der Gesundheits- und Pharmaindustrie sind unter den Top 10, daneben noch Warren Buffets Imperium Berkshire Hathaway und der Ölkonzern Exxon Mobil. Die größte Bank, JP Morgan Chase, kommt erst auf Platz 11.

    Insgesamt machten die 100 größten Konzerne im Jahr 2024 mit zusammen 16,2 Millionen Beschäftigten – etwa 10 Prozent aller Beschäftigten in den USA – einen Umsatz von 13 Billionen US-Dollar. Davon entfielen auf Technologie- und Telekommunikationskonzerne fast 23 Prozent, allein auf die »glorreichen Sieben« gut 15 Prozent, allerdings ist beide Male der ganze Umsatz von Amazon als Technologie gezählt, also auch der Verkauf von Lebensmitteln und Gebrauchsgegenständen aller Art. Ihre Anteile an der Beschäftigung der Top 100 fielen ähnlich aus: gut 23 bzw. knapp 15 Prozent. Die Gesundheits- und Pharmakonzerne nehmen mit 22 Prozent den zweiten Platz ein, und sie brauchten dafür deutlich weniger Personal: Ihr Anteil an der Beschäftigung lag nur bei knapp 13 Prozent. Je Beschäftigtem lag ihr Umsatz bei 1,4 Millionen, bei den Sieben Technologiekonzernen waren es nur 790 Tausend. Allein die Ölkonzerne spielen in einer ganz anderen Liga, hier kam im Durchschnitt auf einen Beschäftigten ein Umsatz von 6,4 Millionen US-Dollar.

    Profite und Investitionen

    Nun kann man auch von einer so gewichtigen Gruppe wie der Fortune 100 nicht erwarten, dass sie für die ge-samte US-Wirtschaft in allen Dimensionen repräsentativ ist. Noch liegen nicht alle gesamtwirtschaftlichen Daten für das letzte Quartal 2025 vor. Für den Zeitraum bis einschließlich September letzten Jahres kann man feststellen, dass bei der Verteilung der Unternehmensprofite auf die verschiedenen Branchen zwar eine leichte Verschiebung zugunsten der Informationsindustrien festzustellen ist. Aber ihr Anteil lag zuletzt bei 8,3 Prozent, über die letzten zwanzig Jahre ist das eher Durchschnitt. Der Einzelhandel steht besser da.

    Und die vielbeschworenen Investitionen in digitale Technologien? Bisher haben sie die Investitionsquote der US-Wirtschaft, den Anteil der privaten Anlageinvestitionen am BIP, nicht wieder auf die 20 Prozent drücken können, die im deutlich breiteren Internetboom im Jahr 2000 einmal erreicht wurden. Wie in den Vorjahren lag sie 2025 bei knapp 18 Prozent.

    Seit 1990 machten die Investitionen in Informationsverarbeitungsanlagen, Software und jegliche Form von Forschung und Entwicklung zusammen immer mindestens 26 Prozent aller privaten Investitionen aus. Die bisherigen Höhepunkte lagen mit 42 bzw. 43 Prozent in den Jahren 2009 und 2020. In beiden Fällen nicht nur aufgrund der hohen Nachfrage, sondern weil andere Investitionen zurückgegangen waren. In den letzten zehn Jahren waren es immer mindestens 35 Prozent. Erst im vierten Quartal 2025 haben diese Investitionen wieder fast 43 Prozent aller privaten Investitionen erreicht. Das ist viel, aber noch kein Rekord. Entscheidend waren dabei nicht die Hardware, sondern die urheberrechtlich geschützten Produkte, also Software, Forschung und Entwicklung.

    Was heißt das? Es zeigt sich hier, dass es vor allem die KI-Unternehmen selbst sind, die in die KI investieren. Und unter ihnen stehen die am besten da, die auch noch andere Schwerpunkte haben, während OpenAI mit seiner KI-Monokultur seine Investitionsplanungen bereits halbierte. Apple wird in der Wirtschaftspresse vorgehalten, den neuen Markt verpennt zu haben. Zu beweisen wäre aber noch, ob es diesen neuen Markt tatsächlich gibt. Ob also andere Konzerne und Unternehmen auf einen gewinnträchtigen Einsatz der globalen KI-Angebote setzen – nicht nur in der Außenwerbung, sondern bei der Planung ihrer Investitionen. Tatsächlich sieht es nicht so aus, als ob die Anbieter ihre Versprechen rascher Effektivitätssteigerungen ohne große Ausgaben für Umstrukturierungen und Anpassung der Produktion realisierbar sind. Die Erfolgsgeschichten handeln alle von einem eingebettetem und gar nicht kostenfreien Einsatz der KI. Der vermeintliche Wachstumsmotor verbraucht Ressourcen und läuft leer.

    Es ist wie mit den Versprechen, die z.B. Microsoft beim Vertrieb seiner Office-Pakete macht. Tatsächlich kann man mit modernen Tabellenkalkulationen, die aber auch als freie Software zugänglich sind, sehr viel sehr effektiv ausrechnen und auswerten. Aber auf den meisten Festplatten führen die Programme eher einen langen Winterschlaf und werden höchstens für einfachste Berechnungen und Sortierungen verwendet. Der den Chefs versprochene Produktivitätsgewinn bleibt aus. Irgendwann merken sie das und kaufen weniger Lizenzen.

    Börsenkurse und Realitäten

    Woher soll dann das Geld fließen? Elon Musk ist schon beim nächsten Schritt angekommen. Nach der Überführung von xAI in seine Raumfahrtfirma will er nun mit SpaceX an die Börse. Schon im Juni soll der Börsengang erfolgen. Nach Berichten ist eine Gesamtbewertung von bis zu 1,75 Billionen Dollar angepeilt, der Teilverkauf soll etwa 75 Milliarden einspielen, frisches Geld, keine hochgeschriebenen Buchwerte. Und deshalb auch für Musk wichtig genug, um sich zu beeilen und der Konkurrenz zuvorzukommen. Auch OpenAI und Antropic wollen in diesem Jahr an der Börse Geld einsammeln. Das wird ein großer Test, wieviel die Investoren zu riskieren bereit sind. Der technologieorientierte Nasdaq hat seit Beginn des Jahres schon 10 Prozent verloren. Er ist wieder da angekommen, wo er Ende 2024 stand, damals voller Vorfreude auf die Trumpschen Steuerkürzungen. Der Einbruch aufgrund des Zollchaos im Frühjahr 2025 war viel tiefer. Auf jeden Fall hat sich eine Befürchtung linksliberaler US-Ökonomen bisher nicht erfüllt: Dass die Scheinblüte an den Börsen zu einer merklichen Zunahme des
    Luxuskonsums der Oberschicht und so zu einem neuen elitären Wachstumsmodell führen könnte.

    Der Anteil des Konsums der privaten Haushalte am BIP lag Ende 2025 bei knapp 68 Prozent, wie schon ein Jahr zuvor. Zwar ist die Umverteilung von unten nach oben offen sichtlich, nur ein sich selbst stabilisierendes Wachstum ist daraus nicht entstanden. Das sogenannte »reale«, also preisveränderungsbereinigte Wirtschaftswachstum lag im ersten Jahr von Trumps zweiter Amtszeit mit 2,1 Prozent unter dem Ergebnis aller Jahre seines Vorgängers Joe Biden; damals waren es immer über 2,5, zuletzt 2,9 und 2,8 Prozent. Ohne den fetischistischen Glauben an die wohltuenden Wirkungen eines wachsenden BIPs zu teilen: Die Veränderung ist real. Nicht ausbleibende Zinssenkungen der FED, sondern »die Märkte« selbst bremsen. Im vierten Quartal lag das Wachstum bei nur mehr 0,7 Prozent – und das war vor dem Angriff auf den Iran und vor der Steigerung der Energiepreise. Kombiniert mit der massiven polizeilichen und sozialen Repression sorgt der US-Präsident höchstselbst dafür, dass ihm auch der arme Mann zum Feind wird, der ihn gewählt hat.

    Kein kampfloses Abtreten

    Das absehbare Scheitern der Trumpschen Politik, auch und gerade der Wirtschaftspolitik, ist kein Grund zu Beruhigung. Zum einen werden die Gruppen, die mit ihm die politische Macht in Washington seit einem Jahr bestimmen, nicht kampflos aufgeben, auch wenn der gesellschaftliche Block zerfällt, der ihn zu seinem spektakulären Comeback getragen hat. Zum anderen braucht es für diesen Kampf tatsächliche, organisierte Alternativen.

    Von Trump enttäuschte Superreiche haben nicht alle vor, sich deshalb in Kalifornien eine Milliardärssteuer von 5 Prozent auf ihr Vermögen gefallen zu lassen. Der Vorschlag der Gewerkschaft SEIU United Healthcare Workers West findet in Umfragen breite Zustimmung. Trotzdem gibt der Gouverneur Gavin Newsom von den Demokraten lieber den geizigen Reichen recht. Entscheidend ist dabei nicht die Furcht vor Umzügen nach Florida und Steuerflucht, sondern die Angst um verärgerte Großspender. Die »No Kings«-Proteste kommen ohne solchen Zuwendungen aus. Newsom nicht.

    Die Aussicht auf ein Ende des aktuellen Investitionszyklus muss man nicht negativ sehen. Aufgrund der weitgehenden Isolierung dieser Investitionen von der gesamtwirtschaftlichen Entwicklung werden die Folgen weniger schwerwiegend sein als beim Platzen der Dot-com-Blase vor 26 Jahren. Die sozialen Risiken der US-Wirtschaftsentwicklung haben mit der wechselhaften Karriere der KI wenig zu tun. Auch eine spätere breitere Anwendung solcher Techniken wird die menschliche Arbeit nicht überflüssig machen.

    Umsonst ist für die Menschheit die Energie der Sonne, schon ihre Nutzung erfordert einigen Aufwand. Die Arbeit wird nicht unnötig, aber anders werden. Die Utopien wie die Dystopien über die Ersetzung von Menschen durch Maschinen verkennen sowohl die Menschen wie die Maschinen.

    Bisher hat jeder große technologische Fortschritt die Illusion hervorgebracht, das »die Arbeit« beendet werden würde und man sich um banale Dinge wie den Vergleich von Aufwand und Ergebnis angesichts baldigen Überflusses nicht mehr kümmern muss. Jeder technologische Umbruch hatte seinen Schlaraffenland-Moment. Unpopulär waren diese Illusionen nicht. Naturnotwendigkeiten und die Erfahrungen mit kommandierter Arbeit sind nichts, was man sich wünschen muss: »Wer Arbeit kennt/und danach rennt/und sich nicht drückt/der ist verrückt.« Doch genutzt hat diese Illusion vom Ende der Arbeit immer nur denen, die die Arbeit der Leute und die arbeitenden Leute gern ignorieren. Denn damit verbunden ist der Verzicht auf die Umgestaltung der gesellschaftlichen Produktion, der Rückzug auf einen Konsumentenstandpunkt. An der Kasse aber haben Leute mit einem kleinen Portemonnaie wenig Einfluss. Die Adelung solcher Ohnmacht durch Verzicht ist auch keine Lösung. Eine menschenfreundliche Welt wäre eine, in der wissenschaftliche Fortschritte dazu da sind, das Leben zu erleichtern. Dazu braucht es viel mehr als korrekte Daten und lernfähige Algorithmen. Dazu braucht es auch mehr als eine lernfähige Gesellschaft. Nötig ist eine experimentierfreudige, neugierige Gesellschaft, die nicht nur vorhandene Muster erkennt, sondern neue ausprobiert und so sich selbst kennenlernen kann.

    Erschienen in: Lunapark21 Heft 68 (Frühjahr 2026) || spezial: KI, Technik, Herrschaft

    Mustererkennung: KI, Technik, Herrschaft

    Zitat aus »Mustererkennung: KI, Technik, Herrschaft«: »Die Erwartung, dass es auch nur auf jede sinnvolle Frage schon eine richtige Antwort gibt, ist selbstverständlich verrückt.« Daneben Heftseite 38 aus lunapark21 heft 68 · Frühjahr 2026.

    Gibt es auf jede sinnvolle Frage eine richtige Antwort? Die Antwort von Radio Jerewan kennen wir: »Im Prinzip ja, aber ist das eine sinnvolle Frage?« Wer nach den Gründen der Popularität von ChatGPT fragt, sollte neben der alltäglichen menschlichen Bequemlichkeit auch die Ideologiegeschichte berücksichtigen. Dort findet sich eine breite Palette von fetischistischen Angeboten einer Weltformel, einer Welterklärung oder Weltanschauung, die sich alle der philosophischen Grundaufgabe der Selbsterkenntnis durch die Lieferung von großen Erzählungen und beeindruckenden Bildern entzogen haben. Im popkulturellen Hype um Künstliche Intelligenz geht es nicht um diese oder jene Verwendung von Machine Learning, die mehr oder weniger geschickt oder sinnvoll ist. Es geht um den Anspruch der Large Language Models (LLM), Antworten auf jede Frage zu geben. Also um ein neues Angebot für ein älteres, zutiefst ideologisches Bedürfnis. Die Erwartung, dass es auch nur auf jede sinnvolle Frage schon eine richtige Antwort gibt, ist selbstverständlich verrückt.

    Verrückt, aber verbreitet. Valentin Voloshinov schrieb 1928: »Sogar in den Humanwissenschaften zeigt sich die Tendenz, die verantwortliche Äußerung zum Problem durch die Darstellung des gegenwärtigen Standes dieses Problems in der Wissenschaft zu ersetzen, versehen mit einer Aufzählung und einer induktiven Herausstellung des ‚gegenwärtig vorherrschenden Standpunkts‘, was auch manchmal für die solideste ‚Lösung‘ des Problems gehalten wird« (Marxismus und Sprachphilosophie). Im Ergebnis wird die eigene Äußerung zu einer Wiedergabe fremder Worte. Automatisierter Konformismus, das ist eine der Verheißungen der Künstlichen Intelligenz: Noch jede Weltanschauung fand ihren irdischen Beruf in der Bestätigung real existierender Autoritäten.

    Tatsächlich funktioniert das Herangehen nur, wenn der Kreis der Fragen auf das jeweils Übliche eingeschränkt wird. Im Bildungssystem wird Schüler:innen antrainiert, für die Prüfung die korrekten Lösungen zu lernen, richtig wiederzugeben, was man von den Lehrkräften gehört hat. Nur geht es dabei nicht um alles, sondern um bestimmte Antworten auf bestimmte Fragen. Schon das ist schwierig genug. Es werden Hilfsmittel vieler Art verwendet, erlaubte wie unerlaubte. Am Ende werden in der Prüfung auch Antworten erfunden, nur um überhaupt etwas zu sagen. Alle diese Tricks werden auch in der KI genutzt. Doch selbst in der bloßen Reproduktion vorhandenen Wissens kommt niemand ohne eigene Anstrengung und Neugier aus. Nicht das Lehrbuch, erst das verstehende Lesen produziert Wissen. Spätestens wenn es um die Anwendung geht, reicht copy&paste nicht mehr aus.

    Manches ist im Lehrbuch gar nicht zu finden. Aber kritisches, das heißt verantwortungsbewusstes Lernen ist anstrengend und liefert nicht immer das gewünschte Ergebnis. Deshalb gibt es viele Gründe, diese Anstrengungen rechtzeitig zu vermeiden: ein Mangel an Ressourcen, an Zeit und Energie. Oder eine umfangreiche Ausstattung mit Reichtum, so dass auch die Verluste nach größeren Misserfolgen problemlos ausgeglichen werden können. Schließlich die Verfügung über ausreichend Macht, um andere für die eigenen Fehler zahlen zu lassen. Sich auf die KI zu verlassen, ist sicher ein Fehler, den Staatschefs oder Unternehmenslenker nicht selbst bezahlen müssen.

    Anfang 2025 standen die Chefs der US-Technologiekonzerne bei seiner Amtseinführung fest hinter Donald Trump. Seitdem haben sich nicht alle Erwartungen und Befürchtungen über die Wirkungen der neuen Technik erfüllt. Einsichten in den Stand der Debatten und der Börsen, zur Nutzung der KI und ihrer Kritik gibt unser Spezial.

    Erschienen in: Lunapark21 Heft 68 (Frühjahr 2026)

    Blick ins Heft [bestellen | abonnieren]