
Die Diskussion um Künstliche Intelligenz ist von großen Versprechen geprägt. Sie reicht von radikaler Produktivitätssteigerung über die Lösung des Fachkräftemangels bis hin zu einer grundlegenden Neuorganisation von Arbeit. Auffällig ist, dass sich diese Erwartungen vor allem auf das Potenzial der Technologie richten, weniger auf ihren konkreten Einsatz.
Gerade in der Softwareentwicklung, einem der zentralen Anwendungsfelder generativer KI, zeigt sich diese Schieflage besonders deutlich. Während KI-Systeme zunehmend als »bessere Programmierer« beworben werden, bleibt die Frage weitgehend unbeantwortet, welche Rolle sie innerhalb historisch gewachsener technischer Infrastrukturen tatsächlich spielen können.
Aktuelle fundierte wissenschaftliche Beiträge lassen jedoch erkennen, dass die Auswirkungen von KI weniger gleichmäßig sind, als oft behauptet wird. Wissenschaftler:innen der Stanford University legten im November eine detaillierte Analyse zum Einfluss von KI auf den US-amerikanischen Software-Arbeitsmarkt vor.
Generation KI
Basierend auf der Auswertung umfangreicher US-Arbeitsmarktdaten zeigen sich dabei auffällige Muster: Während sich für erfahrene Beschäftigte in KI-affinen Berufen bislang kaum negative Effekte nachweisen lassen, gehen vor allem die Beschäftigungszahlen junger Berufseinsteiger:innen deutlich zurück; betroffen ist vor allem die Altersgruppe, die sich gerade im Übergang von Ausbildung oder Studium in den Arbeitsmarkt befindet.
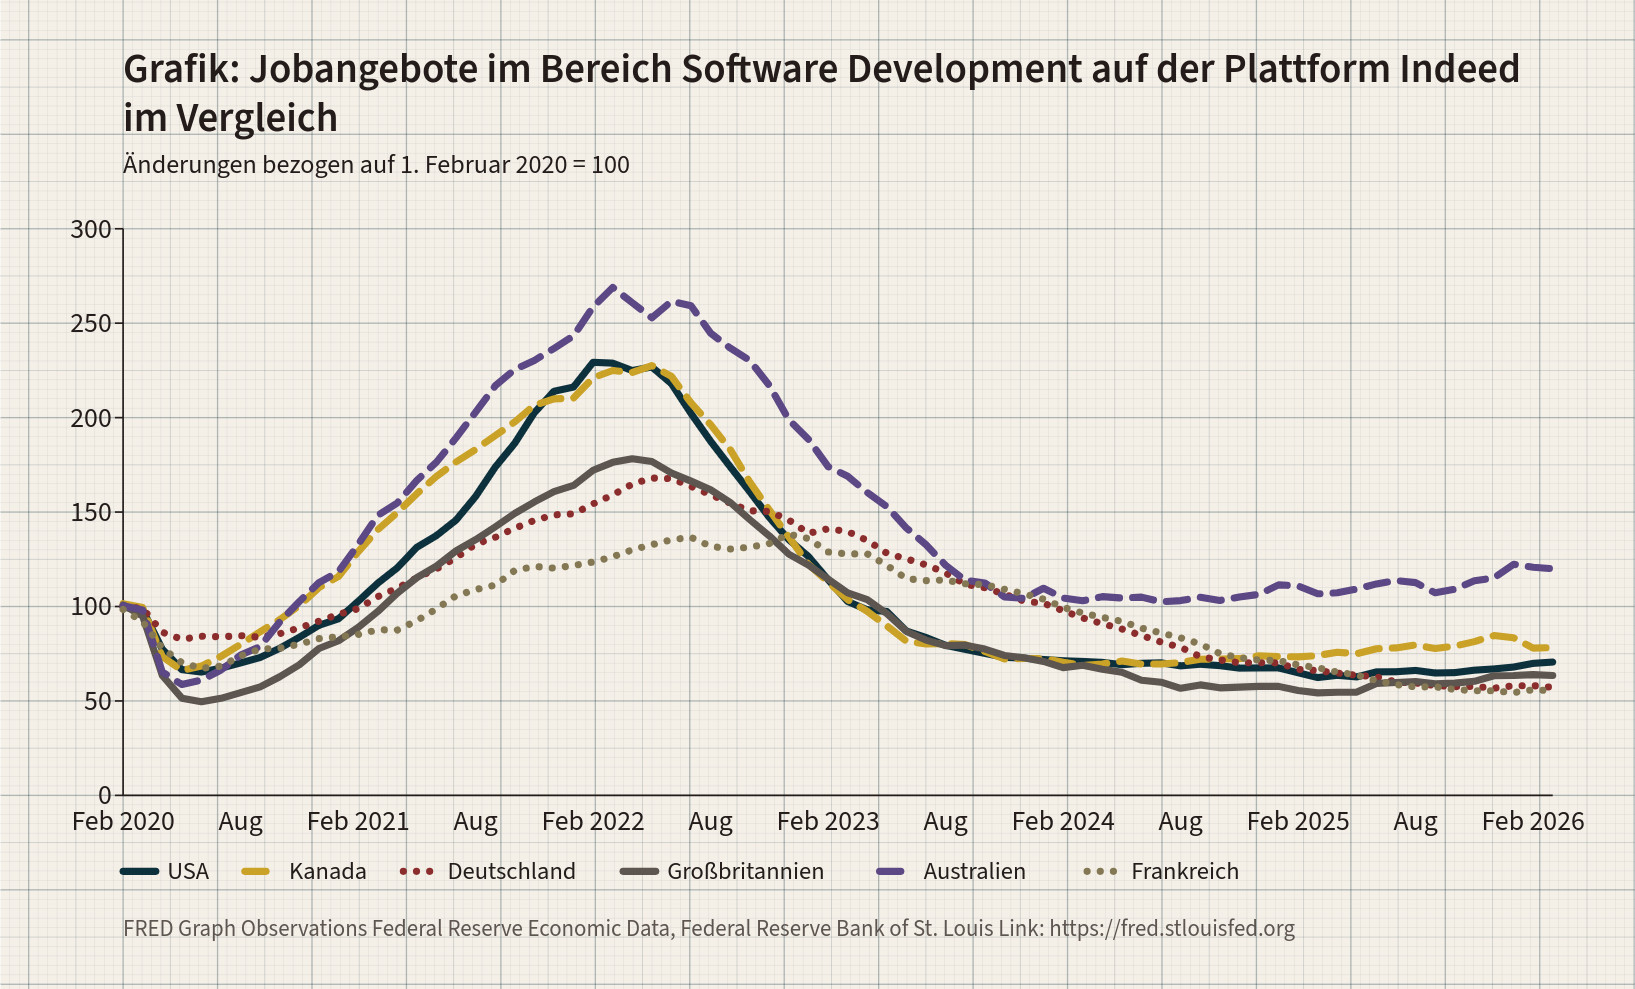
Die Zahl offener Stellen im Softwaresektor ist bereits Anfang 2023 auf das vorpandemische Niveau zurückgekehrt und anschließend weiter gefallen. Der außergewöhnliche Bedarf während der Pandemie markiert somit kein neues Normal, sondern einen vorübergehenden Ausschlag nach oben. In diesen längerfristigen Trend fügt sich die KI-Adaption ein, ohne ihn allein zu bestimmen.
Die von KI-Adaption getriebene Verschiebung auf dem Arbeitsmarkt findet nicht durch Veränderung innerhalb der bestehenden Unternehmensstrukturen statt, sondern entlang eines Generationeneffekts: Einstiegspositionen werden deutlich weniger besetzt, während die übrige Beschäftigung in großen Maßstäben unangetastet bleibt. Besonders ausgeprägt ist dieser Effekt dort, wo KI nicht als ergänzendes Werkzeug eingesetzt wird, sondern Aufgaben vollständig übernimmt.
Der bessere Programmierer
Dass gerade Junior-Stellen besonders anfällig für Verdrängung durch den Einsatz KI sind, überrascht mit Blick auf die Aufgabenstruktur nicht – zumindest auf den ersten Blick. Gestellte Aufgaben sind häufig formalisierbar, ihre Erfüllung einigermaßen objektiv messbar. Oft ähneln sie Lehrbuchfällen – ideal für KI.
Der zweite Blick könnte sich aber auf die Frage richten, wer eigentlich diese Aufgaben definiert hat. Um prototypisch bei den US-Tech-Riesen zu bleiben: Gute algorithmische Lösungen anbieten und halbwegs guten Code produzieren zu können war immer Einstellungsvoraussetzung für Juniorstellen – nicht aber ihr Zweck. Viel schwieriger als Code zu entwickeln, der ein gut beschriebenes Problem löst, ist es, sicherzustellen, dass dieser kleine Abschnitt an Code nichts anderes kaputt macht. Zu lernen, innerhalb schon vorhandener Unternehmenslogiken und digitaler Infrastrukturen selbstständig agieren zu können, ohne dabei diese sog. Sideeffects zu produzieren, ist das übergeordnete, wenn auch selten konkret ausformulierte Qualifizierungsziel vieler Juniorstellen.
Deshalb muss sich der nächste Blick auf diese Mid-Level-Positionen richten, denn hier wird aus Programmierung echte Softwareentwicklung: weg vom Lösen klar definierter Einzelprobleme, hin zur Weiterentwicklung eines historisch gewachsenen Gesamtsystems. Mid-Level-Arbeit zielt nicht darauf, Algorithmen isoliert korrekt implementieren zu können, sondern auf die Befähigung, zu entscheiden, wo im bestehenden Gefüge eingegriffen werden kann, welche Abhängigkeiten betroffen sind und welche impliziten Annahmen ein System schon in sich trägt.
Diese Fähigkeiten entstehen entlang des Qualifikationspfades, für den Junior-Stellen essenziell sind. Dort werden Erfahrungen gesammelt, wie reale Systeme auf Veränderungen reagieren, wo formalisiertes, explizites Wissen endet und implizite, nicht dokumentierte Konventionen beginnen. Fällt dieser Einstieg weg, entsteht kein unmittelbares Problem: Mid- und Senior-Level-Strukturen funktionieren weiter. Langfristig jedoch dürfte die Reproduktionsbasis dieses Erfahrungswissens wegbrechen.
Besonders deutlich wird dies bei der Fähigkeit zum systemischen Debugging: Fehler lassen sich in komplexen Softwaresystemen selten isoliert lokalisieren, sondern erfordern ein historisches Verständnis darüber, warum ein System so gebaut wurde, wie es heute ist. Es entsteht durch Teilnahme, Wiederholung und schrittweise Verantwortungsübernahme – also genau durch jene Rollen, die derzeit am stärksten unter Druck geraten.
2. Lehman’sches Gesetz
Hinzu kommt, dass Code nachvollziehbar, erweiterbar, testbar und langfristig wartbar bleiben muss; das Aufschreiben von Code für die Lösung eines algorithmischen Problems ist der kleinste Anteil der eigentlichen Aufgabe. Dieser Aufwand, eine technische Lösung auch tatsächlich einsatzbereit zu machen und dauerhaft zu halten, wird gerne als technische Schuld beschrieben und kann realisiert werden – oder eben auf später verschoben.
Bereits 1974 beschrieb Meir Lehman diesen Mechanismus präzise, ohne den Begriff der technischen Schuld zu kennen: »Während Software weiterentwickelt wird, steigt ihre Komplexität, es sei denn, es werden Anstrengungen unternommen sie beizubehalten oder zu reduzieren«. Wichtig ist die Unterscheidung zwischen komplexer Software und komplexen Aufgaben: Dass Code komplizierter wird, heißt nicht, dass er kompliziertere Probleme löst – oft ist das Gegenteil der Fall.
Zukunft Vibecode
Technische Schuld ist keine objektiv messbare Kennzahl. Untersuchungen aus den USA zeigen, dass 2022, also noch vor der weiten Adaption von KI in der Software-Industrie, etwa ein Drittel der Arbeitszeit von Softwareentwickler:innen zur Tilgung technischer Schuld verwendet wurde.
Vor diesem Hintergrund lässt sich ein Entwicklungsmuster beobachten, dass als Vibecoding bezeichnet wird: die Orientierung auf möglichst schnelle, KI-gestützte Ergebnisse bei gleichzeitigem Verlust des Blicks für das Gesamtsystem. Anforderungen werden auf hoher Abstraktionsebene formuliert, die konkrete Umsetzung an generative KI delegiert. Das Resultat kann auf den ersten Blick durchaus überzeugend sein: Scheinbar funktionierender Code überstrahlt den Infrastrukturgedanken. Der Fokus liegt auf der algorithmischen Lösung eines Problems – nicht auf der Frage, wie sich diese Lösung in ein bestehendes System einfügt, welche Abhängigkeiten sie erzeugt oder welche Erweiterungen künftig möglich bleiben müssen. Software erscheint so nicht mehr als langfristig zu wartende Infrastruktur, sondern als Abfolge isolierter Teillösungen.
Der kurzfristige Erfolg dieses Vorgehens verdeckt jedoch seine strukturelle Wirkung. Indem Lösungen ohne Blick auf das bestehende Gefüge entstehen, wächst ein System, dessen innere Ordnung nicht mitwächst. Jede weitere Änderung wird aufwendiger, riskanter und schwerer zu überblicken: Die technische Schuld wächst überproportional mit, weil der Vibecode-Ansatz eben keinen Versuch unternimmt, sie zu reduzieren oder wenigstens unter Kontrolle zu halten. Strukturfragen verschwinden nicht, nur weil man sie nicht mehr mitdenkt.
Besonders problematisch wird diese Entwicklung dort, wo menschliches Erfahrungswissen knapp wird. Wenn Systeme zunehmend aus KI-generierten Teillösungen bestehen und zugleich weniger Nachwuchs nachrückt, verlagert sich der Aufwand von der Entwicklung hin zum Debugging – unter deutlich schlechteren Voraussetzungen. Fehler entstehen dann nicht mehr entlang nachvollziehbarer Designentscheidungen, sondern in historisch gewachsenen, inkonsistenten Strukturen, deren innere Logik erst mühsam rekonstruiert werden muss. Debugging wird damit nicht nur technisch anspruchsvoller, sondern auch ökonomisch deutlich teurer.
Beispiel Microslop
Wie Vibecoding in der Praxis aussieht, lässt sich derzeit besonders gut am Beispiel Microsoft beobachten. Kaum ein anderes Unternehmen treibt den Einsatz generativer KI so offensiv voran – sowohl in der internen Entwicklung als auch in seinen Produkten. Zugleich wird das Betriebssystem immer schwerer beherrschbar.
Windows 11 liefert dafür eine Reihe absurder Momentaufnahmen: Funktionen, die grundlegende Abläufe verkomplizieren, Notfall-Updates, um einen Rechner zuverlässig herunterfahren zu können, und ein stetiger Strom neuer KI-gestützter Erweiterungen, während bekannte Probleme bestehen bleiben. Der Eindruck entsteht, dass sichtbare Neuerungen wichtiger sind als die innere Stabilität des Systems.
Genau hier wird Vibecoding konkret. Statt bestehende Grundlagen zu vereinfachen oder zu festigen, werden neue Lösungen auf ein historisch gewachsenes System aufgesetzt. Was kurzfristig als Fortschritt erscheint, erzeugt langfristig eine Umgebung, die sich selbst blockiert: Änderungen werden riskanter, Fehler schwerer einzugrenzen, Verbesserungen immer aufwendiger. Technische Schuld wird so nicht abgebaut, sondern beschleunigt produziert.
Bezeichnend ist auch der Umgang mit dem Begriff des sogenannten »AI-Slop«, mit dem Nutzer:innen die wahrgenommene Qualitätsverschlechterung KI-generierter Inhalte beschreiben. Dass Microsoft-CEO Satya Nadella diesen Begriff öffentlich zurückwies und zugleich betonte, KI müsse in möglichst vielen Bereichen sichtbare Verbesserungen liefern, um ihre gesellschaftliche Akzeptanz zu sichern, macht deutlich: Nicht Tragfähigkeit, sondern schneller Eindruck wird zum Maßstab.
KI als Werkzeug
Der Fairness halber muss allerdings eingeschoben werden: Code ist nicht deshalb schlecht, weil er automatisiert erzeugt wurde. Automatisierte Codegeneration ist vielmehr seit Jahrzehnten eine der wichtigsten Erfolgsvoraussetzungen moderner Softwareentwicklung; sie ermöglicht u.a. erst das Entwickeln in unterschiedlichen Abstraktionsebenen. Bisher allerdings funktionierte sie grundlegend anders: Funktional stark auf einzelne Probleme beschränkt, gut erprobt und dokumentiert. Per Konzept deterministisch und reproduzierbar: Gleiche Anfragen liefern auf gleicher Hardware gleiche Ergebnisse.
Viele Aufgaben ähneln Lehrbuchfällen, sind aber im Detail aufwendig anzupassen, dort steht Zeitaufwand eben nicht in guter Relation zur Komplexität des zu lösenden Problems. Als Recherche- und Orientierungswerkzeug kann KI produktiv sein: Informationen verdichten und kontextualisieren, Wissen zugänglicher machen und den Einstieg in komplexe Problemfelder beschleunigen. Ihre Ergebnisse müssen aber kritisch geprüft und in bestehende Strukturen eingeordnet werden.
Problematisch wird KI in der Softwareentwicklung, wenn sie nicht als zusätzliches Werkzeug, sondern als Ersatz für Softwareentwickler:innen verstanden wird. Sie kann bei der Entwicklung von Code helfen, versteht aber die Einordnung in gewachsene Systeme und Infrastrukturen nicht. Die Verantwortung für funktionierende Softwaresysteme wird menschlich bleiben.
Nico Rohland, Jahrgang 1999, schreibt an seiner Master-Arbeit Computer Engineering. Hat den Kram studiert, damit er dem Computer vorschreiben kann, was er zu tun hat und nicht andersrum. Testet seit einigen Jahren studienbegleitend die Realität in einem mittelständischen Technologie-Unternehmen.
Erschienen in: Lunapark21 Heft 68 (Frühjahr 2026) || spezial: KI, Technik, Herrschaft